先講最重要的:Sora 已經被 OpenAI 收掉了
這篇原本寫於 2024 年 12 月 Sora 剛上線的時候,但情況已經完全不一樣了。OpenAI 在 2026 年 3 月 24 日宣布停止 Sora,網頁版與 App 在 2026 年 4 月 26 日關閉,開發者用的 Sora 2 API 與 Videos API 也將在 2026 年 9 月 24 日停用,官方的棄用清單裡「建議的替代方案」那一欄是空的,意思是沒有接手的產品。
所以下面關於 Remix、Re-cut、Storyboard 這些功能的介紹,現在只能當成一段紀錄看,你已經沒辦法真的去用它了。如果你當初有存東西在裡面,官方也早就提醒過要自己先下載,期限過了資料會永久刪除。
我沒有把這篇刪掉,是因為它記錄了一件值得記住的事:一個話題度那麼高、大家都覺得會改變內容產業的產品,不到一年半就收了。原因不複雜,就是燒錢的速度遠遠超過賺錢的速度,加上版權與變造影片的麻煩一直解不掉。這對做產品的人來說,比那些功能清單有用得多。
當年 Sora 上線的時候是這樣的:隨著 AI 的發展,它不斷改變我們的內容創作方式,2024 年 12 月推出的 Sora 更是讓人覺得「欸!只要我說的出來,就好像和我想像中的一樣」,只要透過輸入簡單的文字提示,Sora 就能生成視覺效果驚人的影片。
60 秒看懂本篇文章
Sora
「Sora」是 OpenAI 推出的 AI 影片生成工具,透過輸入文字、圖片或影片,即可生成全新的影片內容,讓創作變得更簡單高效。
詞源
Sora 的名稱來自日文的「空」,象徵無限的創意與可能性,讓每位創作者都能自由發揮想像力。
可以這樣理解
想像你有一段文字描述,Sora 能夠將其轉換成生動的影片,無需繁瑣的剪輯流程,輕鬆實現你的創意。
Sora 的核心功能
- Remix(重製):修改現有影片中的元素,保持視覺一致性,無需從頭開始製作。
- Re-cut(重新剪輯):協助用戶掌控時間和場景構成,延長或縮短特定片段。
- Loop(迴圈):創建無縫循環的影片片段,適合用於社群媒體。
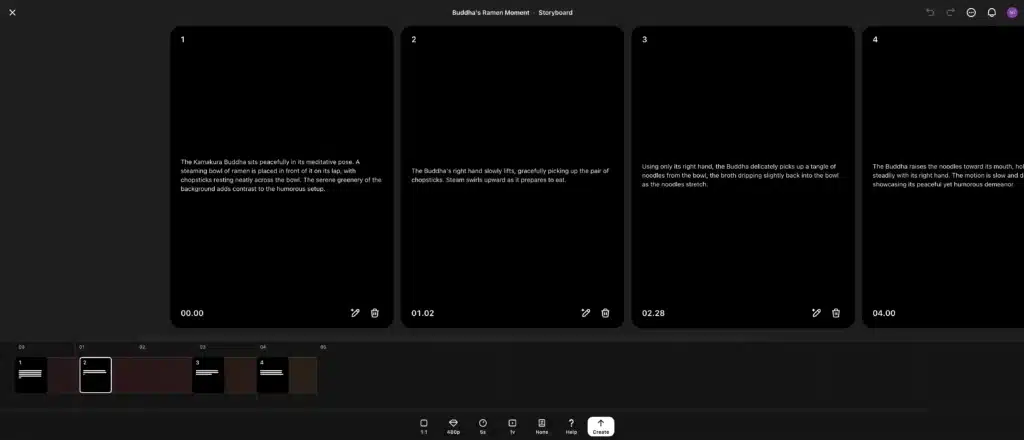
- Storyboard(故事板):提供逐秒控制,讓用戶精確編輯影片敘事。
- Blend(混合):將兩段影片合併為一個連貫的片段,豐富影片內容。
- Style Presets(風格預設):提供豐富的影片模板,適合各種場合需求。
順便學英文
“Sora empowers creators to transform text into stunning videos effortlessly.”
Sora 幫助創作者輕鬆將文字轉換成令人驚豔的影片。
什麼是 Sora?
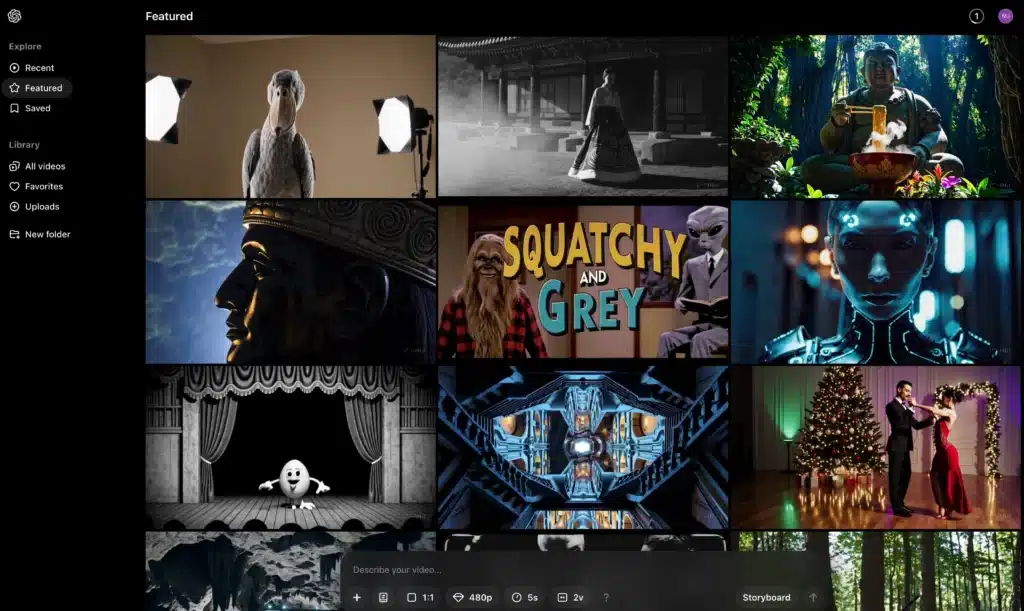
不得不說,Open AI 真的很猛,才剛推出 ChatGPT search 挑戰 Google,現在又在 2024 年的 12 月來個 12 天連發,要是它有股票上市的話,應該漲的很誇張。而 Sora 也是由 OpenAI 推出的 AI 影片生成工具,能根據用戶的文字描述或上傳的圖片,產生出高品質的影片,簡單直觀的設計,讓初學者都能輕鬆上手,下圖是被我試出來不用登入還能看到操作畫面的截圖。
但它為什麼可以那麼厲害產生出這樣子的影片?
研究了一下,我原本以為是用類似 CNN(傳統的卷積神經網路)的作法,實際上核心技術基於擴散模型(Diffusion Model)和 Transformer 架構,而非傳統的卷積神經網路(CNN)。
Sora 的核心技術:Transformer 架構和擴散模型
Sora 的核心技術主要基於 Transformer 架構(2017 年就有了,不要再說它有多新了)和擴散模型(Diffusion Model),這兩種技術讓它可以把文字描述轉換成高品質、連貫的影片。
Transformer 架構
Transformer 是一種模型主要用於自然語言處理(NLP)與電腦視覺(CV)領域,它可以理解文字的意思,還能把圖片切成比較小(像拼圖一樣),然後學會怎麼把它們組合在一起,而 Sora 用 Transformer 來理解文字,決定哪些元素要畫在圖片裡(比如小狗、公園、跑步動作),和處理影片的時間順序,確保動作是連續且合理的。
文字理解
Sora 利用 Transformer 模型來理解文字描述,將輸入文字轉換成向量,也因為 Transformer 擅長處理序列資訊,可以處理文字中的語義和上下文,讓模型理解「小狗在公園跑步」這樣的具體場景。
關鍵畫面生成
在理解文字描述後,Transformer 模型會生成一系列畫面,這些畫面含影片中的重要場景和動作,而 Transformer 的「自注意力機制」幫助模型理解不同文字片段之間的關係,進而生成語義可以連貫的畫面。
時間順序處理
Sora 透過位置編碼(Positional Encoding)和自注意力機制來處理影片的時間邏輯,位置編碼可以將時間資訊融入到模型中,而自注意力機制讓模型能學習不同時間點的圖片之間的關聯,確保影片動作的連貫性和合理性。
擴散模型(Diffusion Model)
簡單講,就是弄髒!把乾淨圖片弄模糊,讓模型知道什麼是「髒」,然後,學習如何根據圖片中的灰塵和模糊,猜測原始的樣子,當模型練習得夠多的時,它可以根據一些提示,例如:「畫一隻穿太空衣的柴犬」,從無到有創造全新的圖片。
前向過程(Forward Process)
擴散模型會先將輸入的圖片逐步添加高斯雜訊,直到完全變成隨機的雜訊,這個過程可以被視為資訊逐漸被「破壞」。
反向過程(Reverse Process)
反向過程則是模型的核心部分,Sora 訓練了一個基於 U-Net 的神經網路模型來學習如何從這些雜訊中逐步去除雜訊,最終恢復為清晰的圖片,這一過程會根據文字描述來生成每一張圖片。
訓練目標:
擴散模型的訓練目標是讓模型學習反向過程的條件機率分佈,也就是給張帶有雜訊的圖片,預測下一步去除雜訊後的圖片,這種目標可以透過去雜訊來實現。
Sora 的文字生成影片的順序
- 文字理解(Transformer 提取文字語義)。
- 關鍵畫面規劃(Transformer 生成主要場景)。
- 單張生成圖片(擴散模型生成每張圖片)。
- 時間邏輯處理(Transformer 處理動作連貫性)。
- 影片輸出(整合所有圖片生成影片)。
如果你和我阿嬤一樣,不知道我在公三小,沒關係,往下看
Sora 是怎麼把文字變成影片的?
你有玩過故事接龍吧?例如,你說:「小狗在公園裡跑」,然後朋友接著說:「跑到湖邊喝水」,最後大家一起想像出一個完整的故事,但不是真心話大冒險那種遊戲。
Sora 的工作就是用電腦做這件事,但它不只是講故事,而是畫出這個故事的畫面,還能讓畫面動起來變成影片!
它有兩個關鍵技巧:
1. 把文字變成圖片
Sora 會先看你寫的文字,比如「小狗在草地上跑」,然後用一個叫擴散模型的技術來畫出這張圖片,擴散模型就像從模糊的草地開始,一點一點畫得越來越清楚,最後畫出小狗的樣子。
2. 把圖像變成影片
接下來,Sora 會用一個方法把圖片變成連續的動作,就好比畫翻頁動畫那樣,畫一張小狗站著、下一張小狗跑一步、再下一張跑遠一點,最後把這些圖片連在一起,變成完整的影片。
為什麼很難辦到?
- 動作要自然:小狗跑起來不能突然「卡住」。
- 細節要準確:不能小狗在圖片裡忽然變成貓。
- 故事要連貫:要確保影片前後是同一隻小狗。
Sora 的使用介面
Sora 的界面設計簡潔明瞭,功能分類清晰,讓用戶能快速找到所需工具。以下是主要介面的介紹:
主畫面功能
- 左側選單:
- Recent:查看最近生成的影片。
- Featured:瀏覽推薦或熱門影片。
- Saved:管理已儲存的影片內容。
- Library:影片資源。
- 右上角選項(登入後才會看到):
- Filter(篩選器):依據提示類型、腳本、混合效果、融合影片和循環特效進行篩選。
- Activity(活動):查看生成記錄。
- 個人檔案設定:更新使用者名稱、主題和通知設定等資訊。
- 下方區域:
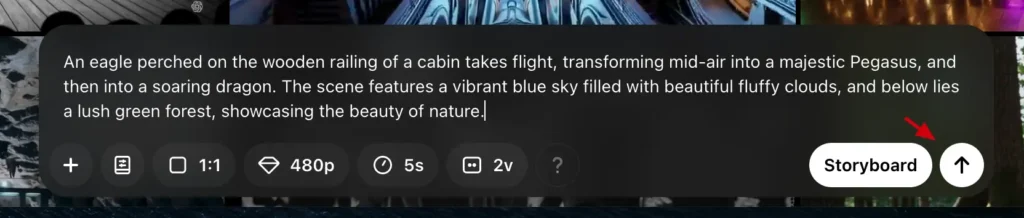
- Prompt 輸入框:輸入文字描述以生成影片。
- Upload an Image:上傳圖片作為影片創作的基礎。
Sora 的主要功能
設定選項
- Themes(主題):選擇深色或淺色介面主題。
- Explore Page(探索頁面):選擇是否將影片公開供其他用戶瀏覽。
- Training(訓練資料):允許或拒絕 Sora 使用你的內容訓練 AI 模型。
影片生成選項
- Presets(預設風格):多種風格選項,包括 Balloon World(氣球世界)、Stop Motion(定格動畫)和 Archival Film(檔案風格)等。
- Resolution(解析度):可選 480p、720p 或 1080p,並支援 16:9、1:1 和 9:16 畫面比例。
- 影片長度:有 5 秒、10 秒、15 秒和 20 秒的選擇。
- Variations(變化版本):一次生成 1 至 4 個不同版本以供比較。
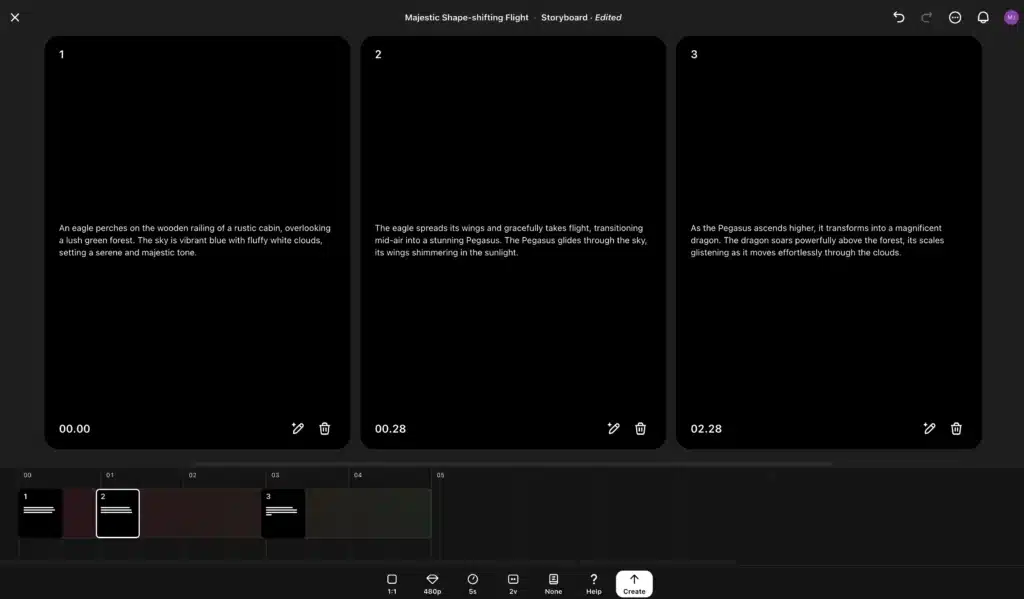
- Storyboard(腳本功能):在時間軸上添加多個提示,生成更豐富的動態效果(每秒換一個提示也真是難為它了)。
互動式影片播放器
- 使用滑鼠滾輪或觸控板控制影片播放進度,方便瀏覽和編輯。
探索與創作
- Explore(探索頁面):瀏覽其他用戶生成的影片。
- Remix(混合功能):基於其他影片進行創作,修改原提示或加入新元素(就是二創啦)。
Sora 的訂閱價格
Sora 與 OpenAI 的 ChatGPT 訂閱服務整合:
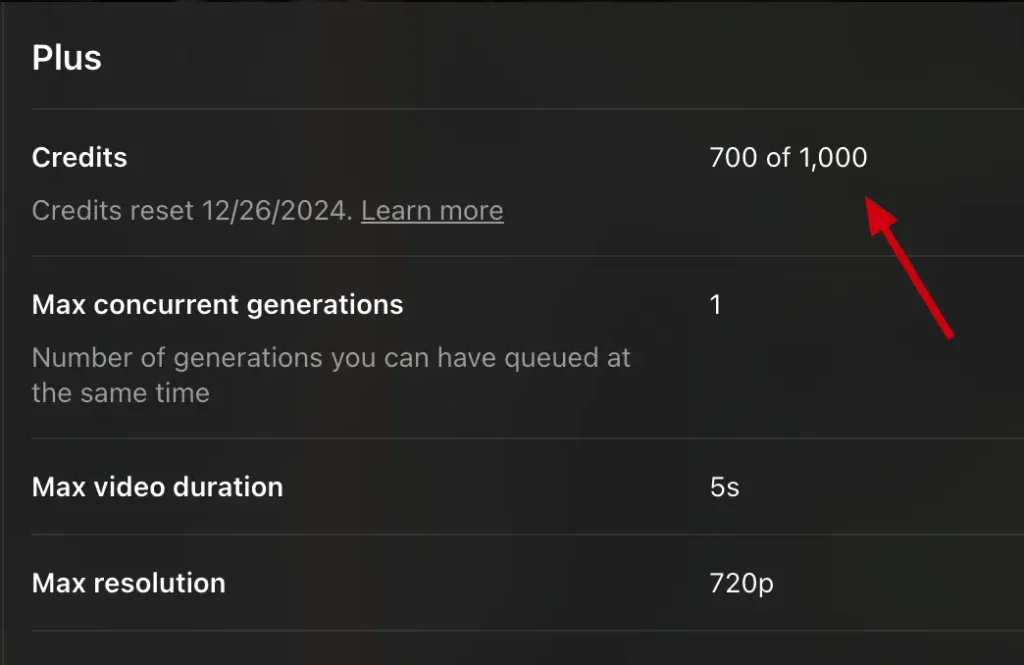
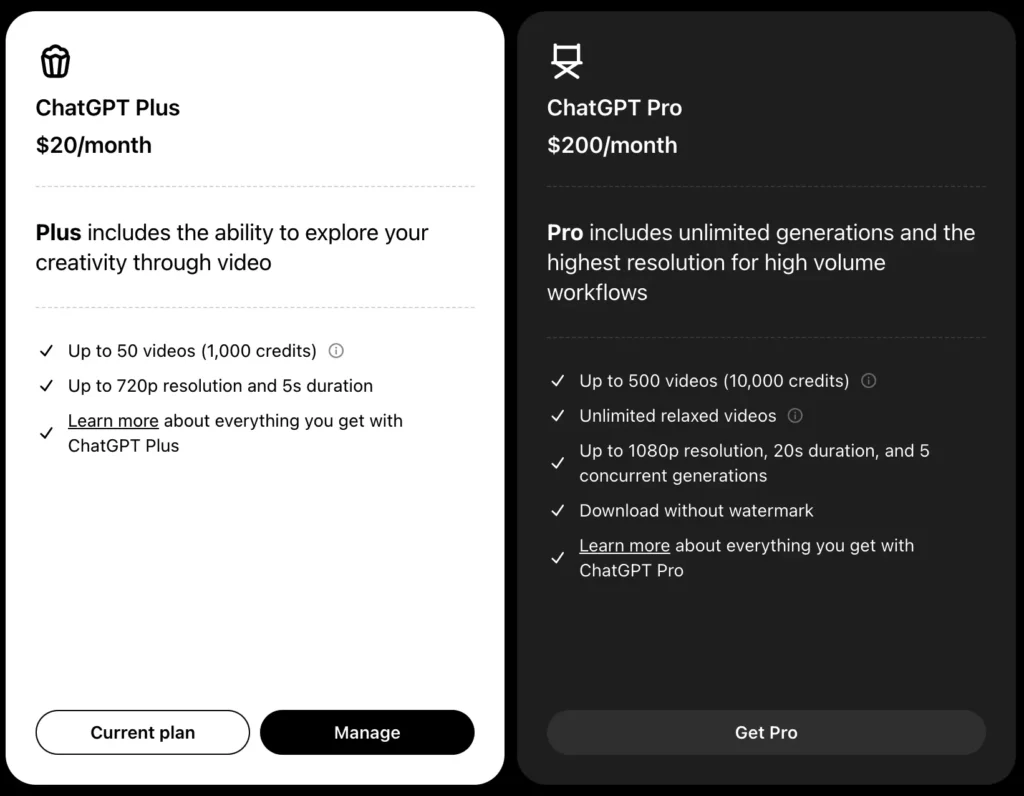
ChatGPT Plus(每月 $20)
- 每月生成 最多 50 部影片(1,000 個 Credits)。
- 最高解析度為 720p。
ChatGPT Pro(每月 $200)
- 每月生成 最多 500 部影片(10,000 個 Credits)。
- 提供「無限制模式影片生成」(生成速度較慢,但數量不限)。
- 最高解析度 1080p,並可下載無浮水印版本。
- 影片長度最高 20 秒。
Sora 的優勢與挑戰
優勢
- 易於上手:簡單直觀的界面設計,非常適合新手。
- 靈活創作:提供多樣化風格、解析度與長度選項,滿足不同用途。
- 進階功能:Storyboard 功能允許精細調整影片腳本,創建更複雜的場景。
挑戰
- 高需求問題:伺服器負載過高可能導致影片生成速度減慢,甚至影響體驗。
- 效果穩定性:生成影片的品質有時不穩定,尤其是對於複雜提示。
Sora 的應用場景
Sora 適用於多種領域(我個人覺得):
- 行銷與品牌推廣:快速建立廣告或社群影片,吸引目光。
- 教育與教學:用於課程製作,提供視覺化的學習內容。
- 娛樂創作:用於個人項目或專業短片的創意實驗。
- 社群媒體:快速生成有趣的影片,用於 Instagram、YouTube Shorts 等平台。
Sora 可能會威脅到誰?
以下是可能受到 Sora 威脅的職業列表:
- 分鏡師
- 概念設計師
- 動畫師
- 特效藝術家
- 影片剪輯師
- 後期製作人員
- 廣告設計師
- 市場行銷內容創作者
- 短影片製作人
- 自媒體內容創作者
參考文獻
- Denoising Diffusion Probabilistic Models
Ho, J., Jain, A., & Abbeel, P. (2020). Denoising diffusion probabilistic models. Advances in Neural Information Processing Systems, 33, 6840-6851. https://doi.org/10.5555/3327748.3327970 - Convergence of the Denoising Diffusion Probabilistic Models
Tai, W., Zhou, F., Trajcevski, G., & Zhong, T. (2023). Revisiting denoising diffusion probabilistic models for speech enhancement: Condition collapse, efficiency and refinement. Proceedings of the AAAI Conference on Artificial Intelligence, 37(11), 13627-13635. https://doi.org/10.1609/aaai.v37i11.26597 - Improving Image Generation with Better Captions
Betker, J., et al. (2023). Improving image generation with better captions. Computer Science. https://cdn.openai.com/papers/dall-e-3.pdf - High-Resolution Image Synthesis with Latent Diffusion Models
Rombach, R., Blattmann, A., Lorenz, D., & Milbrandt, J. (2022). High-resolution image synthesis with latent diffusion models. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2022, 10684-10695. https://doi.org/10.1109/CVPR52688.2022.01065
常見問題
什麼是文字轉換成向量?
「小狗在公園跑來跑去」,電腦聽不懂這句話,因為它不會直接理解人類的文字。我們要把這句話變成電腦能懂的「數字」,這些數字就像玩樂高積木一樣,每一塊積木代表一個意思,比如「小狗」是一塊積木,「公園」又是一塊積木,「跑來跑去」是另一塊積木。當我們把這些積木拼在一起,電腦就知道:「哦,這是一個小狗在公園跑步的故事!」這個拼好的積木,對電腦來說,就是「向量」。
什麼是CNN (卷積神經網路)?
CNN 是一種用來教電腦看懂圖片的技術。你可以把它想像成一個非常厲害的圖像專家,它能一步步拆解圖片,找到有用的資訊,最後告訴你,這圖片到底是什麼。
擴散模型(Diffusion Model)
簡單講,就是弄髒!把乾淨圖片弄模糊,讓模型知道什麼是「髒」,然後,學習如何根據圖片中的灰塵和模糊,猜測原始的樣子,當模型練習得夠多的時,它可以根據一些提示,例如:「畫一隻穿太空衣的柴犬」,從無到有創造全新的圖片。
什麼是 Transformer ?
Transformer 是一種神經網路模型,主要用來處理語言、文字、圖片這些需要理解順序和關係的數據。它是目前許多 AI 技術(像 ChatGPT、BERT、DALL-E 等)的基礎,特別擅長處理自然語言處理(NLP)。
要深入了解 AI 產品經理的基本職責和角色,請參考我的詳細指南:AI 產品經理,我的學習方法