一句話總結:Bing 用得人少,但它背後這套「LLM 理解問題、SLM 快速找答案、TensorRT 加速全程」的組合很值得看。這篇用白話帶你認識 Bing 到底做了什麼努力。
60 秒看懂本篇
Bing 是微軟推出的搜尋引擎,以多媒體搜尋和 AI 技術見長,並跟微軟生態系深度整合。它的設計理念是給你又快又準的結果,結合自然語言處理和互動技術,讓搜尋更簡單。
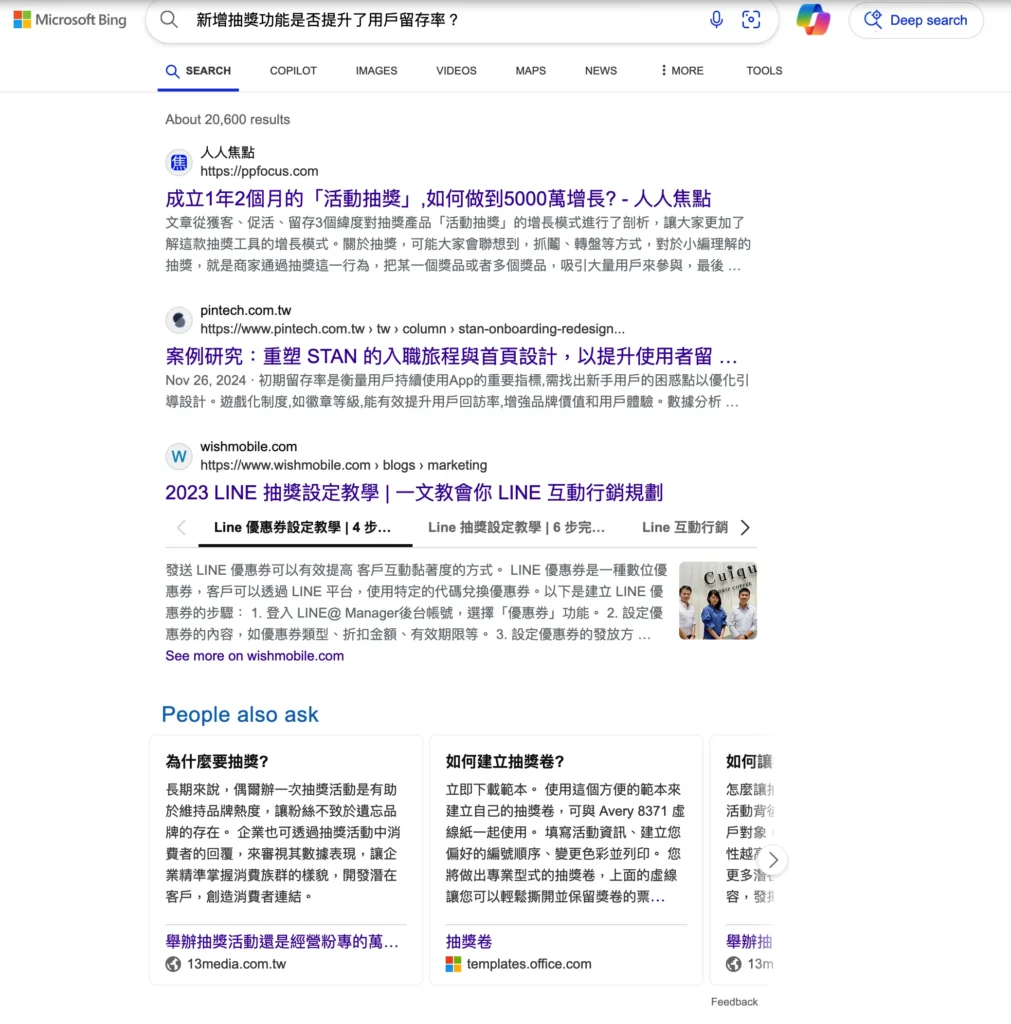
怎麼理解?想像你問:「新增 A 功能是否提升了用戶留存率?」Bing 會直接呈現相關資料,幫你快速找到答案,不必一篇一篇翻。它的核心能力有三塊:圖片與影片搜尋(支援篩選、內容品質高)、AI 功能(結合 ChatGPT 的技術,改善結果相關性)、微軟生態整合(跟 Edge、Windows、Microsoft 365 無縫接合)。
順便學句英文:Bing integrates AI to deliver smarter, faster search results.(Bing 透過 AI 提供更聰明、更快的搜尋結果。)
Bing 簡介:不只搜尋,更懂圖片
Bing 是微軟旗下的搜尋引擎,全球第二大,市佔僅次於 Google,但它有些獨特優勢不容忽視,尤其它還是 ChatGPT 的金主爸爸。
從 Cloudflare 已驗證機器人(Verified Bots)對網站發出請求的數量排名來看,BingBot 排第四。這個排名的依據是:機器人每訪問一個頁面、或下載一個檔案,就會發出一個或多個請求,請求越多通常代表訪問越頻繁、抓得越多,也反映各家企業機器人的活躍程度。
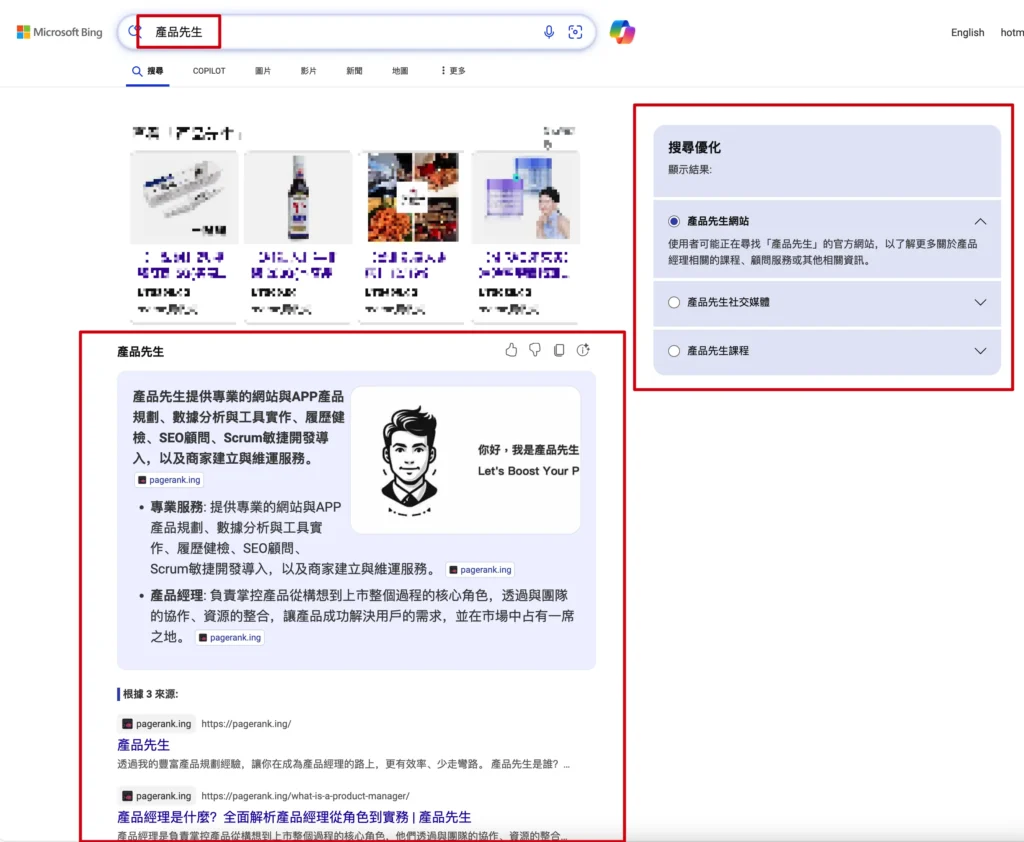
Bing 不只做網頁搜尋,圖片和影片搜尋也很強。它的核心是精準的搜尋演算法,能理解你輸入的關鍵字、抓到你的搜尋意圖,從數十億網頁裡篩出最相關的結果。而且它持續優化自然語言處理,面對複雜或口語化的查詢也能給出令人滿意的答案,這正是本篇重點之一。
圖片搜尋是它的一大亮點,影像識別讓「以圖搜圖」格外精準,你上傳圖片或貼圖片網址,就能找到類似圖片、來源或相關資訊,還能用尺寸、顏色、類型、版權篩選。找高解析度圖片、辨識物體、找圖片出處,我個人覺得它比 Google 更有優勢。影片搜尋也不遜色,支援多個影片平台,可以直接在結果頁預覽片段、不用跳出去,看片更方便。
SLM 和 TensorRT,先用白話講一遍
大型語言模型(LLM)是一種機器學習技術,讓電腦理解和生成自然語言。想像你跟一個很聰明的機器人對話,它不只聽懂你說什麼,還能回答你各種問題,這就是 LLM。
小型語言模型(Small Language Model,SLM)是另一種技術,讓電腦搜尋時更快找到你要的答案。它會挑出最重要的資訊,而不是每個細節都處理,所以更快。
TensorRT 則是加速工具,讓 LLM 和 SLM 這些模型在電腦上跑得更快、更有效率,像是給機器人裝上一個超級引擎。
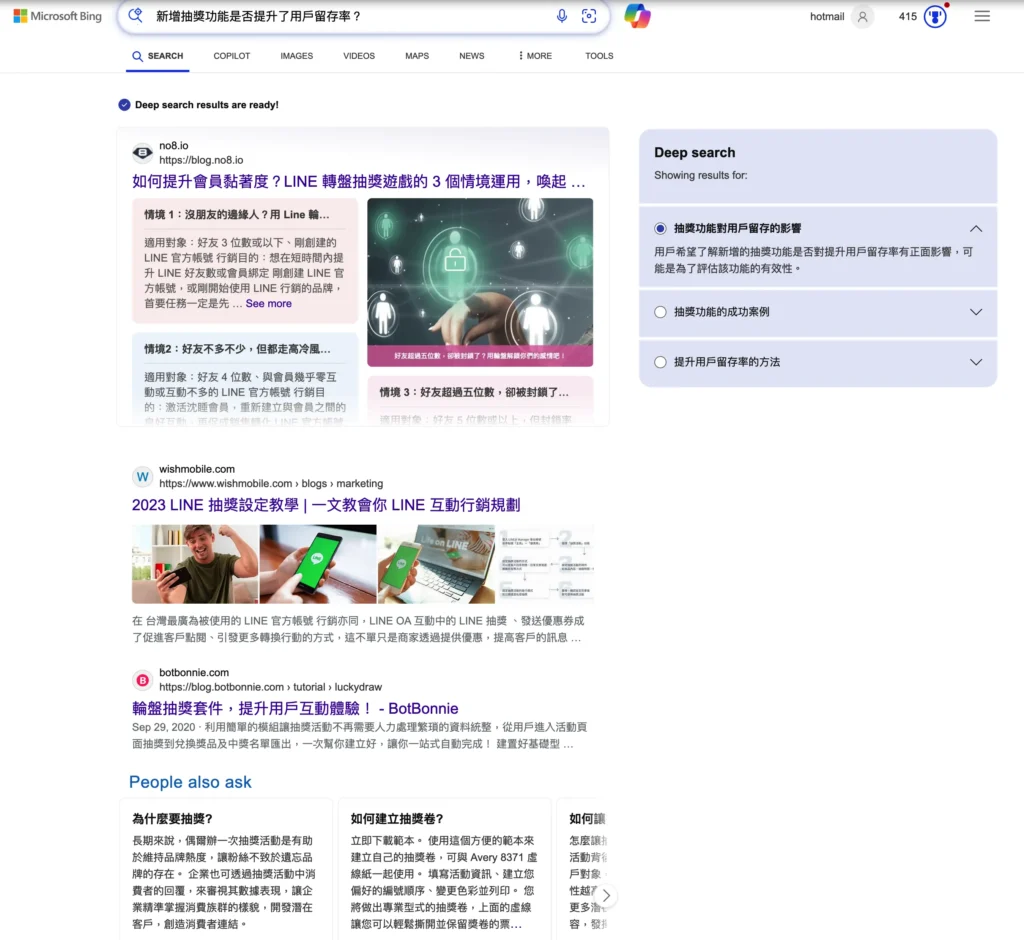
所以現在的 Bing 就是這樣組合:你搜尋時,先用 LLM 理解你的問題,再用 SLM 快速找答案,最後用 TensorRT 加速整個過程,結果就變得又準又快。
小型語言模型(SLM):一種特別的數學模型,處理「非常大量」又不是每筆都同樣重要的數據時,它能識別並只用最重要的資料、忽略不重要的部分,所以算得更快更有效率。打個比方,你有一大堆玩具,但只需要幾個最愛的,SLM 就像幫你把最愛的挑出來,不用每次翻遍全部。
TensorRT:NVIDIA 開發、專為深度學習模型設計的高效推理引擎,用來加速模型在不同硬體上的運行。它能優化和加速模型計算,讓模型跑得更快、用的資源更少。主要功能有三:模型最佳化(移除不必要的運算,讓模型更高效)、精度最佳化(依需要調精度,平衡準確度和速度)、運行加速(用 GPU 等硬體加速,大幅提升推理速度)。想像它給你的電腦裝了一個超強引擎,讓複雜計算飛快完成。
這裡有點模糊沒關係,先記住這些,我們往下看整個流程。
Bing 使用 SLM 和 TensorRT 的流程
1. 關鍵字輸入與初步處理
你在 Bing 搜尋框輸入關鍵字後,系統開始處理:先做語言處理與查詢解析(斷詞、詞性標註等,理解你可能的意圖,通常由專門的 NLP 模組完成);接著 SLM 特徵提取,把關鍵字轉成電腦能理解的稀疏向量,例如把「附近的咖啡廳」拆成「附近」「咖啡廳」再編碼成稀疏數字向量。SLM 的核心優勢就是「稀疏」:只關注跟搜尋意圖最相關的特徵,其餘特徵的權重設為零或接近零,藉此提升速度和效率。
2. 查詢預處理
目的是讓系統更懂你的輸入,把關鍵字變成適合模型處理的格式,分三小步:斷詞與向量化(把關鍵字拆成單詞、用數字向量表示,向量帶有語義資訊);去除干擾(移除停用詞如「的」「啊」,但要看情況判斷,只留跟意圖相關的詞);語義解析(進一步理解詞跟詞的關係,例如「附近的咖啡廳」裡「附近」是修飾「咖啡廳」,抓出查詢的核心,這步可能用到更複雜的 NLP 技術)。
3. 小型語言模型接手
Bing 用 SLM 快速處理查詢,重點兩個。一是快速理解查詢:SLM 比 LLM 更輕量、更高效,能快速分析你的查詢、抓到核心意圖。例如你搜「台北最好吃的牛肉麵」,SLM 會辨識「台北」「最好吃」「牛肉麵」並把它們連起來,理解你在找餐廳推薦。相較 LLM,SLM 大約有 100 倍的處理速度,適合高吞吐量的搜尋場景。二是稀疏特徵提取:它透過學習得到一個稀疏的權重矩陣,大多數元素為零,只有少數跟查詢相關的特徵權重較大。像「的」這種沒實質意義的詞會被忽略,「台北」「牛肉麵」會被重點分析。這種特徵選擇既提高效率、也縮短處理時間。
4. TensorRT 最佳化
經過 SLM 初步篩選的候選結果,會交給一個深度學習排序模型做更精細的排序,而 TensorRT 負責優化這個排序模型的推理過程。拆開來看:
先是模型量化(Model Quantization)。什麼是量化?就像壓縮檔案,把模型裡的大數據精度降低,例如從 FP16(16 位浮點數)轉成 INT8(8 位整數)。SmoothQuant 是其中一種方法,能在降精度的同時維持準確性。為什麼重要?因為它能縮小模型、減少運算資源,讓排序模型更輕、更高效。
接著是 TensorRT 的最佳化,它拿到量化後的模型再做三件事:計算圖最佳化(分析計算流程,把重複的計算合併,本來要算多次的只算一次)、執行序最佳化(重排計算順序,讓每一步都用最快速度完成)、核心融合(把多個小運算併成一個大運算,減少運算核心之間的資料傳輸時間)。
最後是硬體加速:把最佳化後的模型部署到像 Nvidia A100 這樣的 GPU 上,GPU 擅長一次處理大量數據,排序模型就跑得更快、更省資源。
整個過程濃縮成三步:模型瘦身(用 SmoothQuant 縮小模型、降低運算需求,但維持準確)、模型最佳化(用 TensorRT 優化運算流程、合併重複計算、針對硬體調整)、部署到 GPU(放上 Nvidia A100 用硬體加速完成排序)。為什麼這樣做?速度(幾乎即時返回結果)、效率(減少資源消耗、降低成本)、準確性(過程中保留對排序的精準理解,確保結果品質)。
5. 結果生成與排序
目的是從模型提取結果,把最相關的排前面。先做查詢匹配:依你輸入的關鍵字,從龐大資料庫找出可能符合的內容,例如搜「台北的咖啡廳」,系統檢索所有跟「台北」和「咖啡廳」相關的網頁。再由 SLM 和深度學習模型接力:SLM 先快速篩出最相關的候選者,深度學習模型再分析候選的上下文、理解每個結果跟查詢的關聯,確保不只是關鍵字匹配、還真的符合意圖。然後排序與過濾:系統給每個結果一個「相關性分數」,依關鍵字與內容的匹配度、點擊率(熱門結果通常排更前)、上下文是否滿足需求(地點相關性、內容詳盡度)等因素計算。舉例搜「台北的咖啡廳」,排名可能是第 1 名 Google 評價最高的咖啡廳清單、第 2 名附近熱門咖啡廳推薦文、第 3 名台北咖啡廳的部落格分享;過期、失效連結或不相關的結果會被過濾掉。
6. 快速返回結果
經過 TensorRT 最佳化,結果會在低延遲下快速返回。什麼是低延遲?就是從你按下搜尋到看到結果的那段時間,目標是讓你幾乎不用等、結果「即時」顯示(不過我實際測還是要等一下)。怎麼做到的?用 TensorRT 優化模型、減少每次計算時間,讓每個請求更快完成推理;硬體層面靠 Nvidia A100 GPU 的並行處理,同時處理多個查詢。最後把排序好的結果打包成結構化輸出(結果標題、內容摘要、連結),透過網路傳到你的手機或電腦,由瀏覽器或 App 呈現。
Bing 的改進重點
- 查詢效率:SLM 的優化讓你更快拿到結果,大幅降低等待。
- 成本效益:靠 SmoothQuant 和 TensorRT 降低運算成本,替後續技術升級留更多資源。
- 用戶體驗:SLM 理解複雜查詢的能力更強,能給出準確又有情境的結果。
參考文章與文獻
- https://blogs.bing.com/search-quality-insights/December-2024/Bing-s-Transition-to-LLM-SLM-Models-Optimizing-Search-with-TensorRT-LLM
- https://arxiv.org/abs/2211.10438
常見問題
激活值是什麼?在深度學習模型裡,激活值是神經網路每一層的輸出,會被拿去當下一層的輸入。你可以把它想成模型對輸入資料的一種「理解」或「反應」,是處理過程中的重要中間結果。
激活值怎麼運作?假設查詢是「台北的咖啡廳」:第一層辨識出關鍵詞(台北、咖啡廳),生成一組數值當激活值,反映模型對每個詞的重要性理解(例如「台北」0.8、「咖啡廳」0.9);這些激活值再傳到下一層繼續算,直到最終生成結果。
計算圖(Computation Graph)是什麼?它像一張地圖,幫電腦知道怎麼一步步完成運算,讓複雜計算變得有條理、方便最佳化。它用「節點」和「邊」把運算步驟畫出來:節點是每件要做的事(加法、乘法),邊是把上一步的結果送到下一步。例如算 (2+3)×4:第一步先算 2+3 得到中間結果 5,第二步把 5 和 4 相乘得到 20。用節點和邊表示就是:2 和 3 進「加法」節點得到 5,5 和 4 再進「乘法」節點得到 20。
Bing 技術這麼強,為什麼市佔率還是不高?主因有幾個。第一,Google 是市場領導者,品牌效應和生態系太強,使用者早就習慣、預設搜尋引擎地位難撼動。第二,Bing 的體驗跟 Google 差距不明顯,沒有讓人主動切換的理由。第三,Bing 行銷力度較弱、定位模糊,沒把核心優勢講清楚,加上在國際化和行動端影響力不足。總之搜尋市場的競爭不只是技術,更要突破用戶習慣、生態優勢和行銷,這些都還是 Bing 的挑戰。
Bing 為什麼要把 SLM 和 TensorRT 結合?為了同時提升搜尋的效率和精準度,解決搜尋引擎面對的大量查詢與即時性問題。
Bing 是 ChatGPT 的金主,這跟搜尋有什麼關係?Bing 是 OpenAI 的合作夥伴,替 ChatGPT 提供搜尋支援,這種合作讓搜尋和生成式 AI 更緊密結合。
「精度」是什麼?在數學、科學和工程裡,精度(Precision)指數據或運算結果的細緻程度。數值精度指保留的有效位數(小數點後幾位);運算精度指電腦處理數字時的位元數。單精度(Single Precision)用 32 位元、通常到小數點後 7 位(例如 3.1415926);雙精度(Double Precision)用 64 位元、到小數點後 15 到 16 位(例如 3.141592653589793);低精度像 INT8(8 位整數)或 FP16(16 位浮點數),精度更低但更快、更省記憶體(例如只保留 3.14)。
什麼是預處理?預處理(Preprocessing)是準備數據的過程,把原始、雜亂又有雜訊的資料轉成電腦更好理解使用的格式。在 NLP、機器學習和數據分析裡,它是很關鍵的第一步。
斷詞是什麼?斷詞是一種 NLP 技術,把一段文字切成單獨的詞或詞組。對中文、日文、韓文這種不用空格分詞的語言特別重要,因為電腦要先知道每個詞的邊界,才能進一步理解句子。
補充:Bing 進入 AI 搜尋的背景
微軟必應在 2023 年 2 月推出 Bing Chat(後來改名 Copilot),整合基於 OpenAI 的「普羅米修斯(Prometheus)」系統,可以在搜尋結果最上方直接給 AI 回答,或切換成純對話模式。這是 Bing 從傳統搜尋走向 AI 搜尋的重要一步。
要深入了解 AI 產品經理的基本職責和角色,請參考我的詳細指南:AI 產品經理,我的學習方法。
延伸閱讀
想有系統地把 AI 用在產品工作上,可以看我整理的這篇:AI 產品經理,我的學習方法。